Thứ Sáu, 13 tháng 1, 2023

Tăng tốc database index phần 7 - Index chậm 2

Nếu các bạn chưa đọc bài trước có thể đọc tại link này Tăng tốc database index phần 6 -Index kết hợp

Trong phần trước mình đã trình bày về lợi ích đạt được khi đổi vị trí index, tuy nhiên ví dụ chỉ xem xét với 2 câu lệnh SQL. Tuy nhiên việc thay đổi index có thể ảnh hưởng tới tất cả các câu truy vấn trên bảng. Phần này sẽ trình bày về cách database chọn một index và các ảnh hưởng có thể xảy ra khi thay đổi index đã có.
Tăng tốc database index phần 6 - Index kết hợp

Nếu các bạn chưa đọc bài trước có thể đọc tại link này Tăng tốc database index phần 5 -WHERE trên khóa chính

Mặc dù khóa chính được tạo index tự động, và ta biết nếu where theo khóa chính thì chạy rất nhanh rồi, nhưng nếu khóa chính lại bao gồm nhiều trường thì sao trường hợp này được gọi là concatenated index ( multi-column, composite hoặc combined index) thôi mình gọi là Index Kết Hợp cho nó dễ nhé. Nhưng khi tạo theo nhiều trường này có cần quan tâm thứ tự không, hay cần hai trường thì cứ add hai trường, ba trường thì cứ đánh index cho 3 trường không cần thứ tự gì cả? Đáp án là bạn cần rất cẩn thận khi đánh index có nhiều trường, vì thứ tự của nó rất quan trọng. Chi tiết mình sẽ giải thích bên dưới

Tăng tốc database index phần 5 - WHERE trên khóa chính

Nếu các bạn chưa đọc bài trước có thể đọc tại link này Tăng tốc database index phần 4 - Index chậm

Trong những phần trước mình đã mô tả về cách index hoạt động và nguyên nhân làm index chậm, trong các phần sau mình sẽ mô tả cách phát hiện mà tránh những vấn đề này, bắt đầu với WHERE. Lệnh WHERE xác định điều kiện tìm kiếm của một câu lệnh SQL vì vậy việc sử dụng index với where rất quan trọng quyết định tốc độ truy vấn dữ liệu. Mặc dù WHERE là một lệnh ảnh hưởng siêu to khổng lồ tới hiệu năng nhưng nó lại thường không được hiểu đúng, dẫn tới database phải quét qua rất nhiều index. Một lệnh truy vấn chậm thường có nguyên nhân đầu tiên là một lệnh WHERE viết cùi.

Tăng tốc database index phần 4 - Index chậm

Như bài trước đã viết, tốc độ duyệt cây tìm kiếm cân bằng là siêu nhanh, thế mà không hiểu sao mình đã đánh index rồi mà lệnh truy vấn vẫn chậm, mấy thằng cha làm cơ sơ dữ liệu như Larry Ellison nó lừa mình kiếm tiền tỷ phải không? Ngày xửa ngày xưa, từ hồi anh em cây khế còn chơi với nhau, cho tới bây giờ có một giai thoại được truyền tai nhau giữa các dev là index để lâu càng ngày càng chậm, lâu lâu phải rebuild lại index một lần. Thực tế thì không phải như vậy, cây index luôn luôn có một độ sâu cố định và luôn được duy trì ở trạng thái cân bằng. Việc đánh index rồi mà truy vấn vẫn chậm có thể còn hai nguyên nhân nữa. Đầu tiên ta phải hiểu khi truy vấn dữ liệu theo index gồm 3 bước

Tăng tốc database index phần 3 - B-Tree

Index leaf node được lưu trữ theo dạng Linked List về mặt logic, còn về cấu trúc lưu trữ vật lý, mỗi leaf node có thể lưu lung tung, không có thứ tự gì, nó giống một quyền từ điển mà các trang bị xáo trộn, khi ta cần tra từ "Phở" mà đang lật tới trang có từ "Cơm" không có nghĩa là từ Phở chắc chắn ở sau từ Cơm. Để đáp ứng việc tìm kiếm nhanh trong các trang xáo trộn này , database cung cấp một kiểu dữ liệu khác là Cây Tìm Kiếm Cân Bằng (a balanced search tree) gọi ngắn là B-Tree (chú ý các bạn không nên nhầm với Cây nhị phân Binary tree nhé).

Tăng tốc database index phần 2 - Leaf Nodes

Bài trước khái niệm cơ bản

Đầu tiên mình định dịch ra là nút lá, nhưng nghe nó không được hay cho lắm nên quyết định giữ nguyên tên của nó là Leaf Nodes.

Tăng tốc database index phần 1 - khái niệm cơ bản

Phần đầu tiên trong chuỗi bài là các phần liên quan tới database, nhiều bạn thích trình bày các vấn đề khác về database tuy nhiên theo kinh nghiệm cá nhân mình thấy hiểu về index trong db rất quan trọng trong quá trình nâng cao hiệu năng của chương trình, đôi khi chỉ cần đánh index thôi mà tốc độ đang từ rùa bò trở nên tốc độ bàn thờ . Nhưng có phải index luôn giúp truy vấn nhanh hơn không? Đầu tiên là khái niệm index là gì?

Thứ Năm, 12 tháng 1, 2023

Buffer là gì? Sự khác biệt giữa Cache và Buffer

Buffer và Cache có chức năng khá giống nhau, tuy nhiên cả hai lại được ứng dụng để mang lại những lợi ích khác nhau cho hệ thống. Vì vậy, bài viết này sẽ giúp bạn hiểu được Buffer là gì và sự khác biệt giữa nó với Cache.

Thứ Sáu, 6 tháng 1, 2023

Hướng dẫn cài đặt MariaDB Galera Cluster

MariaDB là hệ thống cơ sở dữ liệu quan hệ ( Database Management System) phổ biến hiện nay. Được tách ra mã mở do cộng đồng phát triển của hệ quản trị cơ sở dữ liệu MySQL.

Thứ Năm, 29 tháng 12, 2022

Cấu hình chặn DDL trong Oracle Database

Mục đích: Chặn thao tác DDL (drop table, create table, drop procedure, drop package,...) để đóng bắng trước khi migration chính thức.

Thứ Ba, 20 tháng 12, 2022

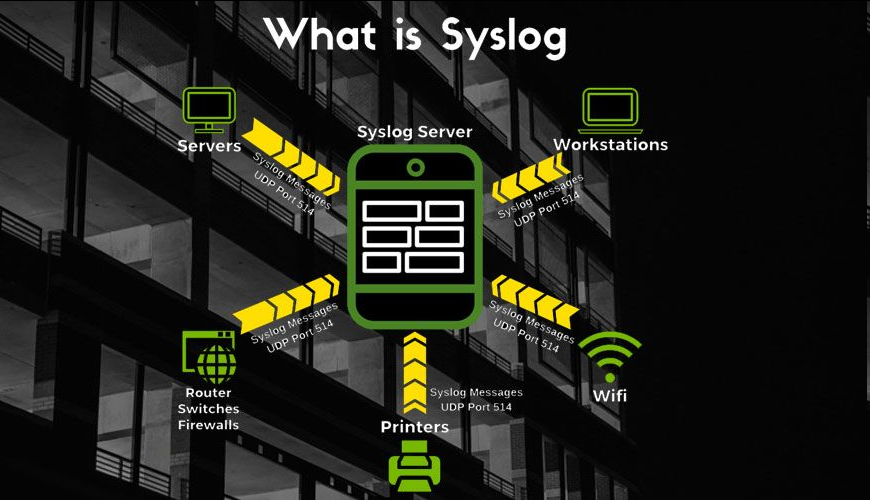
Tổng quan về Log, Syslog, Rsyslog, Log tập trung

I. Log là gì?

  • Log ghi lại liên tục các thông báo về hoạt động của cả hệ thống hoặc của các dịch vụ được triển khai trên hệ thống và file tương ứng. Log file thường là các file văn bản thông thường dưới dạng “clear text” tức là bạn có thể dễ dàng đọc được nó, vì thế có thể sử dụng các trình soạn thảo văn bản (vi, vim, nano…) hoặc các trình xem văn bản thông thường (cat, tailf, head…) là có thể xem được file log.

Thứ Tư, 14 tháng 12, 2022

[VIP5] Quản lý Index Partition từ A-Z trong Oracle Database

1.CHECK

-- Check index partition unusable cả DB

select * from dba_ind_partitions where status!='USABLE' and index_owner not in ('SYS','SYSTEM') order by index_owner, index_name;

Thứ Hai, 12 tháng 12, 2022

VACUUM FULL và REINDEX trong database PostgreSQL

Nhân tiện có bạn hỏi về REINDEX nên mình viết bài này để giải thích thêm về REINDEX và VACUUM FULL, khi nào phải thực hiện các thao tác này và cần chú ý những gì khi sử dụng chức năng này. Trong bài viết về VACUUM, mình có giải thích về chức năng và các xử lý mà VACUUM thực hiện. But chưa nói về 2 chức năng liên quan này.

VACUUM trong cơ sở dữ liệu PostgreSQL là gì?

VACUUM và chức năng autovacuum

Tại sao PostgreSQL cần VACUUM ?

  1. Dung lượng đĩa cứng có thể full
    Khác với các RDBMS khác (như MySQL), khi người dùng chạy lệnh DELETE hay UPDATE, PostgreSQL không xoá dữ liệu cũ đi luôn mà chỉ đánh dấu "đó là dữ liệu đã bị xoá".

Thứ Bảy, 3 tháng 12, 2022

Temporary Undo trong Cơ sở dữ liệu Oracle 12c

Một tính năng khá "thú vị" của các bảng global temporary (GTT) là các undo segment của chúng được lưu trữ trong undo tablespace thông thường, đồng thời nó lại được bảo vệ bằng redo entry Điều này gặp phải một số vấn đề.

[VIP5] Bí kíp truy cập SQL*Plus, DB bị treo với sqlplus -prelim

Ví dụ: nếu bạn không thể đăng nhập vào cơ sở dữ liệu do vượt quá số lượng tiến trình tối đa ORA-00020 hoặc bị treo do cao tải database, thì có khả năng bạn có thể sử dụng tùy chọn -prelim.

Load Balancing là gì? Các loại Load Balancer và lợi ích của Load Balancer

Làm thế nào để đảm bảo rằng các trang web không bị quá tải khi lượt truy cập quá nhiều cùng một lúc? Bạn lo lắng vì server chính gặp sự cố, không có server nào để thay thế và tiếp tục các tiến trình đang dang dở, dẫn đến website rơi vào tình trạng downtime, gây những tổn thất và ảnh hưởng to lớn đến trải nghiệm người dùng, doanh thu, uy tín và hiệu quả hoạt động của doanh nghiệp. Hãy xem xét việc sử dụng công nghệ hiện đại có tên là load balancing.

Định nghĩa về Load Balancing

Định nghĩa

Load balancing là một thành phần quan trọng của cơ sở hạ tầng thường được sử dụng để cải thiện hiệu suất và độ tin cậy của các trang web, các ứng dụng, cơ sở dữ liệu và các dịch vụ khác bằng cách phân phối khối lượng công việc trên nhiều máy chủ.

Các tham số liên quan đến checkpoint trong Oracle Database

Các tham số liên quan đến checkpoint gồm 4 tham số sau đây

+ LOG_CHECKPOINT_INTERVAL
+ LOG_CHECKPOINT_TIMEOUT
+ FAST_START_MTTR_TARGET
+ LOG_CHECKPOINTS_TO_ALERT

Thứ Sáu, 2 tháng 12, 2022

ĐỌC NHIỀU

Trần Văn Bình - Oracle Database Master